この記事のまとめ
canonical(正規URL)とは、同じ内容が複数のURLから見られるときに、代表として扱ってほしい1本のURLをGoogleに伝えるための記述です。ただしGoogle検索セントラルの「正規化とは」には「正規化の希望を伝えることはできますが、確実ではありません」と明記されており、canonical は命令ではなくヒントです(Googleが別のURLを正規に選ぶことがあります)。個人ブログで重複が起きるのは末尾スラッシュ・www・http/https・パラメータ付きURL・AMPなどで、公式は重複コンテンツ自体を「Google のスパムに関するポリシーの違反にはなりません」としています。気づく場所は Search Console の「ページ」レポートで、公式ヘルプが「重複していますが、ユーザーが正規ページとして選択していません」と見出しに掲げている理由などが並びます(画面に出ている文言はこの見出しと一字一句そろっていません)。
結論を先に書きます。canonical タグは命令ではありません。Google公式のドキュメントに「確実ではありません」と書かれていて、指定したのにGoogleが別のURLを正規として選ぶことがあります。だから「canonicalを書いたのに重複が消えない」は、設定ミスとは限りません。
canonical は正規URLを決める複数のシグナルのうちの1つで、他と矛盾していると押し負けます。この記事はその構造を書きます。
なお内容の違う2記事が同じキーワードで競合する話は別問題で、キーワードカニバリゼーションの確認方法の領分です。ここで扱うのは「同じ本文が複数のURLで見られる」技術的な重複だけです。直す記事の順番を機械に決めさせる手もありますが、まずURLの重複を片付けたほうが数字が読めるようになります。
Search ConsoleのZIPを読み込むと、候補の判定と1記事分の診断カードを無料で確認できます。登録は不要です。ZIPが無い場合は、診断カードの見本を確認できます。
canonical(正規URL)とは何か
canonical(正規URL)とは、同じ内容が複数のURLから見られるときに、その中で代表として扱ってほしい1本のURLをGoogleに伝えるための記述です。HTMLの <head> に1行入れるだけのものです。
<link rel="canonical" href="https://example.com/dresses/green-dresses" />
Google側の呼び方は「正規化」で、公式ドキュメントは「正規化とは、そのコンテンツを代表する正規 URL を選択するプロセスです」と定義しています。選ぶのはGoogleです。canonical は選ぶ主体ではなく、選ばせるための材料です。その材料は1つではありません。
正規化で重要となる要素は多くありません。HTTP と HTTPS のどちらでページが提供されているか、リダイレクト、サイトマップ内での URL の有無、rel="canonical" link アノテーションです。
4つあります。canonical はそのうちの1つです。続く一文が、この記事でいちばん重要な引用です。
これらの手法を使って Google に希望を伝えることはできますが、さまざまな理由から Google が別のページを正規として選択する場合もあります。つまり、正規化の希望を伝えることはできますが、確実ではありません。
canonical を命令だと思って読むと、この挙動が全部バグに見えます。ヒントだと分かれば、次に確かめる場所が決まります。
なぜ指定しても別のURLが正規に選ばれるのか
順番から書きます。Googleは2段階で処理しています。
- クラスタ化。公式の記述は「メイン コンテンツが非常に似通っている複数のページを Google が見つけた場合、それらをまとめてクラスタ化します」。まず「これは同じ内容だ」というグループが作られます
- 代表の選出。そのクラスタから、集めたシグナルに基づいて1つを正規としてマークします
canonical が効くのは2段階目だけです。 1段階目でクラスタに入っていなければ、指定した相手は候補にも入りません。そして2段階目には、さきほどの4つが同時に入ってきます。「canonicalが効かない」ように見えるとき、起きているのはこれです。
- canonical は www 付きを指しているのに、内部リンクは www 無しで貼ってある — 公式は「サイト内でリンクする場合は、重複 URL ではなく正規 URL にリンクしてください」と書いています
- サイトマップに、canonical で指定していないほうのURLが入っている — 公式は「複数の異なる URL を同じページの正規版として指定しないでください」と明示しています
- canonical が相対パスで書かれている /
<head>の外にある — 公式は絶対パスを推奨し、「<head>セクションに指定されている場合にのみ受け入れられる」としています
4つが別々のURLを指していると、canonical だけ正しくても弱いのです。公式は「これらの方法を組み合わせて使用するとより効果的です」とも書いています。やるべきことは「canonicalを書く」ではなく「シグナルを1本のURLに揃える」です。
個人ブログで実際に重複が起きている場所
公式が挙げる重複の原因は「地域の違い」「デバイスの違い」「プロトコルの違い」「サイトの機能」「意図的でないバリエーション」の5つです。個人ブログの言葉に置き換えると、確認すべき場所は次の8つになります。確かめ方は共通で、2つのURLを両方開き、どちらも表示されるかを見ます(片方が片方に転送されるなら揃っています)。
| 場所 | 同じ内容が出る2つのURL | 公式での扱い |
|---|---|---|
| 末尾スラッシュ | /foo と /foo/ | 公式ブログで別URLと明記 |
| www の有無 | example.com と www.example.com | 複数URLの例として明示 |
| http / https | http:// と https:// | 「プロトコルの違い」 |
| パラメータ付きURL | /foo と /foo?utm_source=x | gclid付きURLを例示 |
| 大文字小文字 | /apple と /APPLE | 「別々の URL として扱います」 |
| AMP・別URLのモバイル版 | 通常版と /amp/ など | 「デバイスの違い」 |
| 一覧の並び替え・絞り込み | /category/seo と ?sort= 付き | 「サイトの機能」 |
| テスト用サイトが残っている | 本番と staging | 「意図的でないバリエーション」 |
末尾スラッシュについては、Googleの公式ブログ(2010年)に「末尾にスラッシュが付いているか否かを問わず、前述の各 URL を個別に(かつ同等に)扱います」と書かれています。ありとなしは、Googleにとって別のURLです。
なおタグ一覧やカテゴリ一覧そのものは、記事本文の重複とは別の話です。一覧は抜粋の集まりで、記事1本と同じ内容ではありません。増えるのは並び替えや絞り込みのパラメータが付いたときです。印刷用ページを別URLで出している場合は公式の原因リストに無い類型ですが、同じ本文が2つのURLから見える条件は満たします。
Search Console のどこで気づくか
重複はSearch Console の「ページ」(ページ インデックス登録)レポートで見つかります。「未登録」の理由のうち、重複に関係するのは次の3つです。下の表記は公式ヘルプの見出しをそのまま写したものです。とくに1行目は、画面に出ている文言と一字一句そろっていません(画面の文言をそのまま検索してもこのヘルプに辿り着きにくいことがあるのは、この表記の差があるためです)。
| 理由の表記 | 公式の説明 | 読み取ること |
|---|---|---|
| 重複していますが、ユーザーが正規ページとして選択していません | 「Google が別のページを正規として選択したため、検索結果に表示されません」 | canonical を書いていない側。公式は「これはエラーではなく、意図したとおりに機能しています」とも書く |
| 重複しています。Google により、ユーザーがマークしたページとは異なるページが正規ページとして選択されました | 「Google は別の URL のほうが正規ページとして適切と判断しています」 | 「canonicalはヒント」の実物。指定は届いたが採用されていない |
| 代替ページ(適切な canonical タグあり) | AMPやモバイル版/PC版などの「代替」としてマークされた状態 | 公式に「これ以上の対処は必要ありません」とある。触らなくてよい |
1行目の「代替ページ(適切な canonical タグあり)」は、こちらの指定がそのとおりに扱われた報告です。正常なのに未登録側へ並ぶ理由と、確認すべき1点は 「代替ページ(適切な canonical タグあり)」はエラーではない、確認は1点だけにまとめました。
1行目は、画面では「重複しています。ユーザーにより正規ページとして選択されていません」という語順で見かける行です。この行が数十件並んでいて放置してよいのかを先に知りたい場合は、「重複しています。ユーザーにより正規ページとして選択されていません」は放置していいのかに判断の分かれ目だけをまとめてあります。
2行目が出ているときは、URL検査ツールで「Google が選択した正規 URL」と「ユーザーが指定した正規 URL」を見比べます。食い違っていれば、4つのシグナルのどれかが逆を向いています。
注意点が1つあります。公式ヘルプは重複側について「このページは検索結果に表示されません」と書いています。表示されないURLには表示回数が積み上がらないので、検索パフォーマンスの「ページ」CSVには重複側の行が並びにくくなります。CSVを見ていても重複には気づけません。気づく場所は「ページ」レポートの側です。
URL検査ツールの操作手順と除外理由の全一覧はサーチコンソールでインデックスを確認する方法にまとめてあります。
canonical・noindex・301 の使い分けと、取り得る4つの手
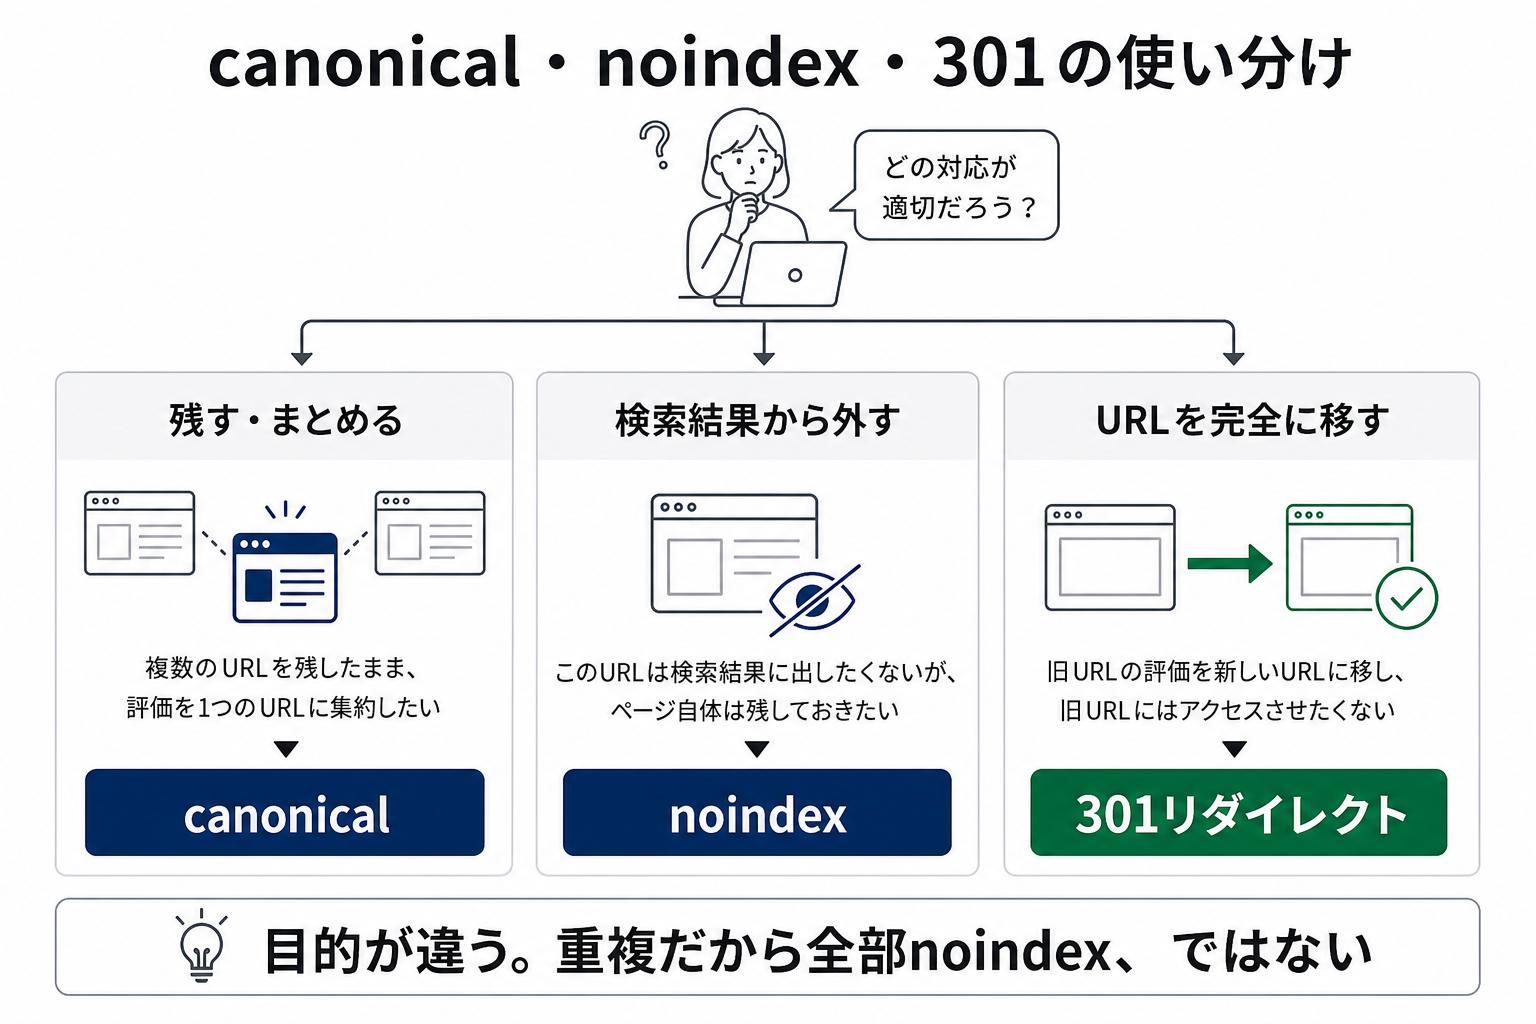
手は3つで、公式が想定している用途が違います。シグナルの強さは公式が順番を書いており、リダイレクトがもっとも強く、次に rel="canonical"、サイトマップは「シグナルとしては弱いものです」という順です。
| canonical | noindex | 301(永続的なリダイレクト) | |
|---|---|---|---|
| そのURLは開けるか | 開ける | 開ける | 開けない(転送される) |
| Googleへの伝わり方 | 強いシグナル。ただしヒント | ディレクティブ(従われる) | もっとも強いシグナル |
| 公式が想定する用途 | 重複を残したまま代表を決める | 検索結果に出したくないページ | 「重複ページを廃止するときにのみ使用します」 |
| 取り違えると起きること | Googleが別のURLを正規に選ぶことがある | そのページが検索結果から完全に削除される | 残したいURLが開けなくなる |
いちばん危ない取り違えは noindex です。公式は正規化の目的で noindex を使うことを「そのページが Google 検索から完全にブロックされてしまうため、おすすめしません」としています(原文はこの記事のFAQに引いています)。「正規化の目的で robots.txt ファイルを使用しないでください」とも書かれています。
これを踏まえた選択肢を、公式の記述に沿って並べます。上から順に手間が増えます。
- 何もしない。公式ブログは「最適な動作ではありませんが、問題のあるものではまったくありません」と書いています。canonicalの指定も公式は「いずれも必須ではありません」としています
- 自己参照の canonical を全ページに入れる。公式は「正規ページ自体(自己参照正規)に rel="canonical" リンクを含めてください」と推奨しています
- シグナルを揃える。内部リンク・サイトマップ・canonical・http(s) を同じURLに向けます。ここが効く場所です
- 301で1本に寄せる。重複側を今後使わないと決めた場合だけ
個人ブログで費用対効果が高いのは2と3です。末尾スラッシュ・www・httpsはサーバーやCMSの設定で片方に寄せられることが多く、1回直せば全記事に効きます。ただし「直せば順位が上がる」とは書けません。公式が挙げる canonical の効能はシグナルの統合・表示させたいURLの指定・指標の追跡・クロール時間の削減で、順位の話は書かれていません。改善の余地がある、までにしておきます。
301の設定手順はURLを変えるとSEO評価は切れる、記事を1本に統合すべきか削除すべきかの判断は伸びない記事はリライトか、統合か、削除かの領分です。重複を片付けたあとでページCSVを入れて取りこぼしを見ると、URLが割れていない数字で判定できます。
Search ConsoleのZIPを読み込むと、候補の判定と1記事分の診断カードを無料で確認できます。登録は不要です。ZIPが無い場合は、診断カードの見本を確認できます。
よくある質問
canonicalタグを設定したのに、Googleが別のURLを正規に選びます。設定ミスですか
ミスとは限りません。Google検索セントラルの「正規化とは」に「正規化の希望を伝えることはできますが、確実ではありません」と明記されていて、canonical は命令ではなくヒントです。効く要素はhttp/https・リダイレクト・サイトマップ・canonical の4つで、 canonical はその1つにすぎません。内部リンクやサイトマップが別のURLを指していると押し負けます。URL検査ツールで「Google が選択した正規 URL」と「ユーザーが指定した正規 URL」を見比べ、 4つを同じURLに揃えてください。
重複コンテンツがあると、Googleからペナルティを受けますか
公式は「違反にはなりません」と書いています。「正規化とは」の原文は「サイト上で重複コンテンツが発生することは通常のことであり、 Google のスパムに関するポリシーの違反にはなりません」です。ただし同じ段落に、同一コンテンツが多数のURLから見られる状態はユーザー体験の悪化につながり、パフォーマンスの追跡が難しくなる可能性があるとも書かれています。罰の話ではなく、測りにくくなる話です。
重複しているページに noindex を入れて消してしまえばいいのでは
公式が推奨していない手です。正規URLの指定方法を説明したドキュメントに「1 つのサイト内で正規ページの選択を妨げる手段として noindex を使用することは、そのページが Google 検索から完全にブロックされてしまうため、おすすめしません」と書かれています。noindex は検索結果からの削除で、代表を決める仕組みではありません。同じテンプレートから出ている2つのURLでは、noindex は両方に出力されます。片方だけ落とすつもりで、本体まで検索結果から消えることになり得ます。
末尾スラッシュは、あり・なしのどちらに揃えるべきですか
どちらでもかまいません。揃っていることが重要です。2010年のGoogle公式ブログは「どちらの URL でも選択できます」と書いています。選んだほうを内部リンク・サイトマップ・canonical のすべてで使ってください。運用中ならいま検索結果に出ているほうに合わせるのが安全です。
まとめ
- canonical(正規URL)とは、同じ内容が複数のURLから見られるときに、代表として扱ってほしい1本のURLをGoogleに伝える記述。選ぶのはGoogle
- 公式に「正規化の希望を伝えることはできますが、確実ではありません」と明記されている。命令ではなくヒントで、別のURLが選ばれることがある
- 効く要素はhttp/https・リダイレクト・サイトマップ・canonical の4つ。canonicalだけ正しくても、他が逆を向いていると押し負ける
- 重複が起きるのは末尾スラッシュ・www・http/https・パラメータ付きURL・大文字小文字・ AMP・一覧の並び替え・残ったテストサイトの8か所
- 気づく場所はSearch Console の「ページ」レポート。重複側は検索結果に表示されないので、パフォーマンスの「ページ」CSVでは気づけない
- 正規化のために noindex を使うのは公式が推奨していない。301は「重複ページを廃止するときにのみ」
ここから先は、私が作ったツールの話です。
順位のわりにクリックされていないページを並べ替えるツールを作りました。 Search Console のエクスポートをZIPのまま落とすだけで、掲載順位4.0〜20.5位・表示回数100回以上のページだけを拾い、改善余地スコア(表示回数 × 期待CTRとの差)の大きい順に並べます。判定と候補3記事の改善余地スコアの確認、そのうち1記事分の診断カードまでは無料で、残りの診断カードが2,980円(税込・買い切り)です。月額課金や自動更新はありません。ログインも不要です。 CSVファイルそのものはブラウザの外に出ません(診断カードを出すときに選んだ1ページのURL・数値・入力したキーワードを、「ページタイトルを取得する」を押したときに判定に出たページのURLを最大10件送ります)。
⚠️ 向かない人がいます。まずこの記事の目的にはまったく使えません。重複URLの検出はできません。読み込むのは「ページ」CSVで、重複側のURLは検索結果に表示されないため行としてほぼ入ってきません。canonical もリダイレクトも、このツールは触りません。表示回数が2桁で止まっているブログでも、判定できるページが出ません。公開日や更新日も判定できません(ページCSVにその情報が入っていないためです)。
Search ConsoleのZIPを読み込むと、候補の判定と1記事分の診断カードを無料で確認できます。登録は不要です。ZIPが無い場合は、診断カードの見本を確認できます。