この記事のまとめ
構造化データは検索順位を動かすための仕組みではありません。 Google の公式ドキュメントに書かれている効果は、ページの意図を伝えると「Google はそのページをより正確に理解できるようになります」という理解の助けと、リッチリザルトの対象になりうることまでで、正しくマークアップしても表示は保証されないと明記され、構造化データの手動対策もウェブ検索の順位には影響しないと書かれています。個人ブログが入れる順番は①BlogPosting(公開日・更新日・著者)②BreadcrumbList ③その他で、FAQPage は2026年5月7日以降 Google 検索に表示されなくなったため後回しで構いません。このサイトも2026年8月17日に記事66本(当時)へ BlogPosting を入れ、本文とJSON-LDが食い違う形になる FAQPage は見送りました。
結論から書きます。構造化データを入れても、それだけで検索順位は動きません。変わるのは「検索結果での見え方」と「機械への伝わり方」の2つだけです。
なので「入れると評価が上がる」を期待して半日使うと、期待とずれます。逆に「いつ書いて、いつ直して、誰が書いた記事なのか」を確実に渡すという目的なら、費用対効果は悪くありません。この記事はその線引きと、入れる順番の話です。
なお、構造化データを入れてもクリック数は自動では増えません。クリックを増やすのはタイトルと説明文で、どのページを直すべきかは数字で決まります。そちらは自分のSearchConsoleのデータで確かめられますが、先にマークアップの話を済ませます。
記事のURLを貼るだけで、本文の改善点を無料で確認できます。登録は不要です。Search ConsoleのZIPを読み込むと、候補の判定と1記事分の診断カードも無料です。
構造化データとは何か
構造化データとは、ページに書いてある内容を検索エンジンが機械的に読み取れる決まった形式で書き添えたもので、Google はこれをページ内容の理解と、検索結果での見せ方(リッチリザルト)の判断に使います。
公式ドキュメントの言い方では「a standardized format for providing information about a page and classifying the page content」(ページについての情報を提供し、ページ内容を分類するための標準化された形式)です。書き方は複数ありますが、Google が推奨しているのはJSON-LD —— <script type="application/ld+json"> の中にJSONを書く形式です。このJSONの括弧やカンマが崩れていると、Search Console には「解析不能な構造化データ」として出ます。その見つけ方は「解析不能な構造化データ」とは?サーチコンソールに出たときの原因の見つけ方に書きました。
つまり JSON-LD とは、構造化データを書く形式の1つです。公式ドキュメントは JSON-LD・microdata・RDFa の3つを挙げ、正しく実装されていればどれも有効としたうえで、ほとんどの場合は JSON-LD を推奨しています。中に書く型やプロパティの名前は主に schema.org のボキャブラリで、これを一般に「スキーマ マークアップ」と呼ぶこともあります(Google の文書から引いた呼び名ではありません)。どんな種類があり、Google 検索でどれが使えるかの一覧はGoogle 検索がサポートする構造化データ マークアップにあります。
大事なのは「書き添えたもの」であって「本文の代わり」ではない点です。本文に無いことを構造化データにだけ書くのは違反になります(後半で公式の文言を出します)。
なぜ順位のレバーにならないのか
現象として「入れても順位が変わらない」と言うだけなら体感の話になります。ドキュメントを読むと、そもそも順位の系統と表示の系統が分かれていることが分かります。
構造化データの一般ガイドラインには、構造化データが原因で手動対策を受けた場合についてこう書かれています。「a page loses eligibility for appearance as a rich result; it doesn't affect how the page ranks in Google web search」—— リッチリザルトに出る資格を失うが、ウェブ検索での順位には影響しない、と。
つまり構造化データを壊しても順位は落ちないのです。落ちないものは、上げる方向にも効いていないと考えるのが自然です。ペナルティの効き先が「表示の資格」だけである、というのが構造の答えです。
もう1つ、同じページに「Google does not guarantee that your structured data will show up in search results, even if your page is marked up correctly」とあります。正しく書いても表示は保証されません。構造化データは「できる状態にする」ものであって「そうなる」ものではない(原文は "enables a feature to be present, it does not guarantee that it will be present")という設計です。
出典: General Structured Data Guidelines(2026年10月10日に本文を確認。最終更新日は英語版 2026-07-10 UTC、日本語版 2026-09-16 UTC)
「CTRが25%上がった」事例を自分に当てはめない
構造化データの入門ページには導入事例が並んでいます。 Rotten Tomatoes が10万ページに入れてCTRが25%高かった、 Nestlé はリッチリザルトとして出たページのCTRが82%高かった、といった数字です。
これは公式に載っている本当の数字です。ただしいずれも「リッチリザルトが実際に出る種類のページ」の事例で、映画・レシピ・商品のように検索結果の見た目が変わるものです。個人ブログに BlogPosting を入れると同じ比率で増える、とは書かれていません。
個人ブログの記事ページで見た目として変わりうるのは、良くても日付やタイトルの表示が正確になるあたりまでです。 Article のドキュメントも効果を「show better title text, images, and date information」と書いています。 アイキャッチを構造化データの image に入れている場合も、確認した Google の公式ページに順位が上がるとの記述は無く、関わるのは見え方だという話はアイキャッチはSEOに効く?に書きました。星やカルーセルが出るわけではありません。
出典: Introduction to structured data markup in Google Search / Article (Article, NewsArticle, BlogPosting) structured data(2026年10月10日に本文を確認。最終更新日は Introduction が英語版 2025-12-10 UTC・日本語版 2025-12-18 UTC、Article が英語版 2026-09-08 UTC)
個人ブログが入れる順番
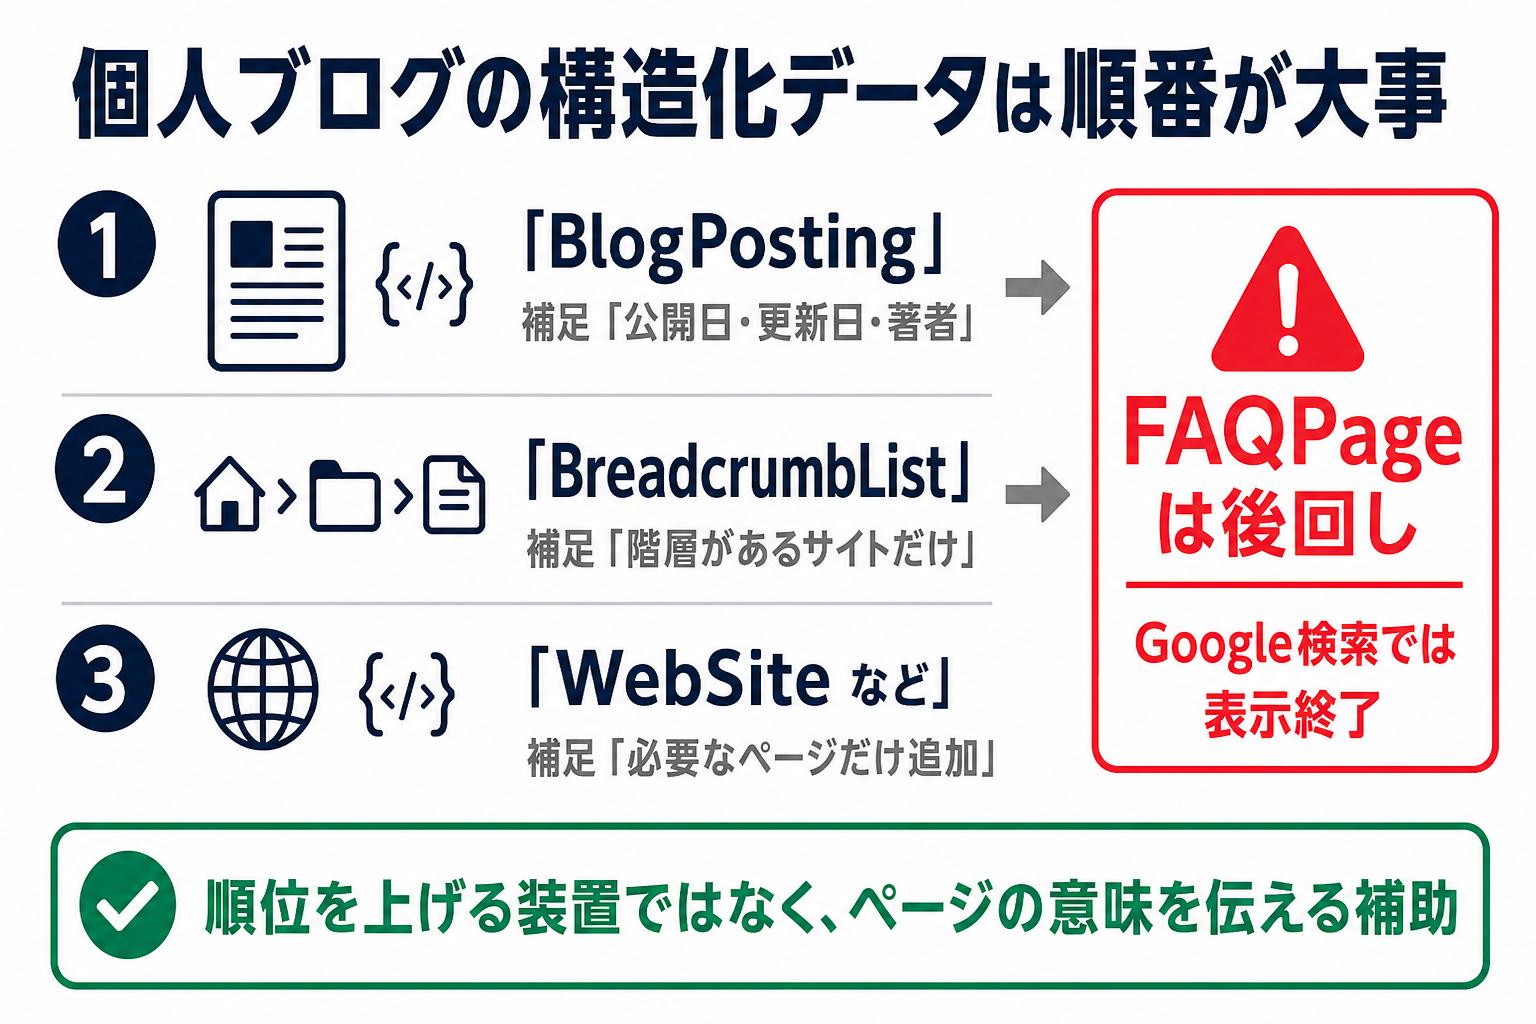
全部入れる必要はありません。自分のサイトに実体があるものだけを、効く順に入れます。
| 優先度 | 種類 | 何のために入れるか |
|---|---|---|
| ① | Article / BlogPosting | 公開日・更新日・著者を機械可読な形で渡す。数字や基準を扱う記事では「いつの情報か」が読者の判断材料になる |
| ② | BreadcrumbList | サイト内での位置を渡す。ただし画面にパンくずが出ているサイトに限る。検索結果に出るのはデスクトップのみ |
| ③ | WebSite / Organization / WebApplication など | サイトやサービスの正体を渡す。トップページ向け。実体が無いなら書かない |
| 後回し | FAQPage | 2026年5月7日以降、Google 検索に表示されない(次のH2で説明) |
①が最初に来る理由は、入れる手間がいちばん軽く、渡せる情報がいちばん具体的だからです。Article には必須プロパティがありません("There are no required properties")。自分のサイトで確実に言える項目 —— 見出し・公開日・更新日・著者・URL —— だけを書けば足ります。 入れた後の書き方の検証(いわゆるスキーマの検証)は、Google の構造化データ ガイドラインが技術的な誤りのほとんどを検出できるとしているリッチリザルト テストか、Search Console の URL 検査ツールで行います。
なお著者を渡せば順位が上がる、という意味ではありません。公式ドキュメントで著者情報について確認できるのは「正確な著者の情報を追加することを強くおすすめします」という推奨までで、そこで何をどこまで書けばいいのか(本名や住所が要るのか)は運営者情報ページは必要か・著者情報はSEOに効くか、確認できたのは推奨までで整理しました。
日付は ISO 8601 形式で、タイムゾーンを付けることが推奨されています。付けない場合は Googlebot のタイムゾーンが使われる、とドキュメントに書かれています。
②のパンくずには、知っておくべき制約があります。2025年1月22日の更新で、パンくずのドキュメントに「they only appear on desktop search results, not mobile」という記載が加わりました。小さい画面では切り詰められて有用でないため、という理由です。モバイル中心のブログでは、見返りがその分小さくなります。
そしてもう1点。画面にパンくずが表示されていないサイトで BreadcrumbList だけ入れると、ガイドラインの「ページの読者に表示されないコンテンツをマークアップしないでください。」に当たります。入れる前に、まず画面にパンくずを出すのが順番です。このサイトでは、2026年9月13日に記事の上部へ「ホーム / ブログ / 記事タイトル」を出したのと同時に、同じ並びの BreadcrumbList を入れました。 自分で書く必要があるのか、テーマがすでに出しているのかの確かめ方はパンくずリストの構造化データとは?表示 URL の後半を指定する仕組みにまとめました。
③の WebSite をトップページに置くと、その name で検索結果に出るサイト名の希望を Google に伝えられますが、指定しても根拠が弱いと判断されるとドメイン名などが出ることがあり、出ない・違うときにホームページで確かめることは検索結果のサイト名が出ない・違うのはなぜ?にまとめました。
FAQPage を後回しにしてよい理由
「FAQを書いて FAQPage でマークアップすれば検索結果に質問が並ぶ」という解説は、今も大量に残っています。この情報は古くなっています。検索セントラルの更新履歴で辿れる範囲を、そのまま並べます。
- 2023年9月: FAQ構造化データのドキュメントが改訂され、FAQリッチリザルトは「well-known, authoritative government and health websites」にのみ表示されると明記された(同じ更新で How-to のドキュメントは削除)
- 2026年5月8日: 非推奨の通知が追加。「This feature will no longer appear in Google Search starting May 7, 2026」
- 2026年6月15日: ドキュメントごと削除。理由は「The FAQ rich result feature is no longer shown in Google Search results」
2023年の時点で、個人ブログは対象外になっていました。そして2026年5月7日以降は、対象だったサイトでも表示されません。リッチリザルト目的で FAQPage を書く理由は、もう残っていません。
ただし「FAQPage を書くと損をする」とまでは言えません。AI検索や他の読み手がJSON-LDをどう使っているかは公表されていないので、価値がゼロだと確認できたわけではないのです。言えるのは優先度の話だけです —— リッチリザルトという見返りが無くなった以上、限られた作業時間を最初に使う場所ではありません。
AI検索に引用されるための書き方(定義文の置き方、結論の先出し、表と箇条書き)はLLMO対策にまとめました。この記事はマークアップの話に絞っています。
全記事にBlogPostingを入れたときに、何を見送ったか
ここが実際にやった話です。2026年8月17日まで、このサイトの記事ページにはJSON-LDが1つもありませんでした。公開日と更新日はHTMLに出ていましたが、機械可読な形では渡せていませんでした。
掲載順位ごとのクリック率のように「いつの数字か」で意味が変わる話を扱っているサイトなので、日付を確実に渡せないのは損が大きい。そこで当時の全記事(66本)に BlogPosting を入れました(実装は app/blog/[slug]/page.tsx の ArticleJsonLd)。
入れたのは、記事一覧のデータにすでにある値だけです。
headline      … 記事タイトル(画面のh1と同じ値)
datePublished … 公開日(画面に出している日付と同じ値)
dateModified  … 更新日。無ければ公開日を使う
author        … 著者(記事末尾の筆者情報と同じ人)
url / publisher / inLanguage
ポイントはすべて「画面に出ている値そのもの」を使っていることです。タイトルも日付も著者も、JSON-LD用に別で書いていません。1つの定義から、画面とJSON-LDの両方を作っています。ただし、画面の日付と datePublished・dateModified をそろえても、検索結果に出る日付は Google が複数の要素から推定するもので指定した値がそのまま出るとは限らず、出ている日付がおかしいときにページのどの日付と一致するかから見る手順は検索結果の日付がおかしいのはなぜ?にまとめました。
そして FAQPage は入れませんでした。入れられなかった、というのが正確です。
トップページにも、FAQ の配列から画面の質問リストと FAQPage の JSON-LD を作る形で入れていましたが、2026年9月13日の改修で外し、今は FAQPage を /faq のページだけに出しています。/faq のページも、FAQを配列として1か所に持ち、画面の質問リストとJSON-LDの両方をその配列から生成する形です。 記事の中に置くFAQの節のほうを、表示が終わった今も置く理由と質問の拾い方はよくある質問はSEOに効く?FAQ表示終了後も置く理由にまとめました。
【/faq のページ】食い違わない形
  FAQ配列(1か所) ──┬─→ 画面の質問リスト
                     └─→ FAQPage の JSON-LD

【記事ページ】食い違いうる形なので入れなかった
  JSXの中のFAQ ────→ 画面
JSON-LDに手書き ─→ FAQPage ← 片方だけ直る日が来る記事のFAQは、本文と同じJSXの中に見出しと段落として書いてあります。同じ配列から両方を作ることがこの構造ではできません。 JSON-LDに書き写す形にすると、本文のFAQを直したときに片方だけ古くなります。
1本なら気をつければ済む話です。数十本あると、いつか必ず片方だけ直します。食い違いを防ぐのは注意力ではなく、食い違えない形にすることです。その形が作れなかったので、入れませんでした。
補足すると、この判断は結果的に外側の変化にも耐えました。FAQリッチリザルト自体が2026年5月7日以降なくなっているので、書き写して同期し続ける手間を負う理由も無かったことになります。
入れてはいけない2つのパターン
入れる話の裏側です。この2つは、入れないより悪くなります。
1つ目。ページに見えていない内容を書く。一般ガイドラインの文言は「Don't mark up content that is not visible to readers of the page」で、例として「JSON-LD マークアップでパフォーマーが記述されている場合、HTML の本文でも同じパフォーマーが記述されている必要があります」が挙げられています。「構造化データはページ コンテンツを正確に表している必要があります」(英語版は "must be a true representation of the page content") とも書かれています。
よくやってしまう形は、画面に書いていないFAQをJSON-LDに足す、画面に出していない評価やレビューを書く、書いていない著者名を書く、です。ガイドライン違反は、順位ではなく「表示の資格」を失う形で返ってきます。
2つ目。本文とJSON-LDを別々に書いて、食い違わせる。こちらのほうが、ずっと高い頻度で起きます。悪意ではなく、更新の手数が2倍あるからです。
本文を直した。JSON-LDを直し忘れた。これだけで、機械が読む内容と人が読む内容が別のものになります。更新日を直したのに dateModified が古い、タイトルを変えたのに headline が前のまま、というのが典型です。
対処は「気をつける」ではありません。同じ値を2か所に書かない形に変えることです。画面に出す値とJSON-LDに入れる値を、同じ変数・同じ配列から取る。テンプレートを使っているなら、そこに入っているデータをそのまま流す。手で写す工程が残っている限り、いつか食い違います。
なお dateModified を省略すると、更新日を機械可読な形で渡す手段が1つ減ります。 Google は複数の手がかりから日付を推定するので、省略した結果どう扱われるかはこちらで決められません。このサイトでは更新日が無い記事は公開日を入れる形にしました。日付そのものの扱い方は古い記事の情報を更新するリライトの方法に書いています。リライトのときに公開日と更新日のどちらを動かすか、画面の日付と datePublished・dateModified が揃っているかをページのソースで確かめる手順はリライトしたら更新日は変える?にあります。
ここまでがマークアップの話です。構造化データを入れてもクリック数は増えません。増やすのはタイトルと説明文で、どの記事を直すかは掲載順位と表示回数から決まります。自分のサイトでどのページが取りこぼしているかは、SearchConsoleのCSVを入れれば一覧で出せます。
記事のURLを貼るだけで、本文の改善点を無料で確認できます。登録は不要です。Search ConsoleのZIPを読み込むと、候補の判定と1記事分の診断カードも無料です。
構造化データの入れ方やSearch Consoleの表示で迷ったら
HTMLを触らずに構造化データを伝えたいならGoogleのデータハイライターとは?今も開ける専用URLと使い方に、入れたあとにSearch Consoleの「拡張」に出るエラーや警告を直すかどうかはサーチコンソールの拡張レポートとは、構造化データのエラーは順位ではないに書きました。「動画再生ページに動画がありません」と出て直すべきか迷ったときは「動画再生ページに動画がありません」は直す?記事自体は登録済みが答えています。
よくある質問
構造化データを入れると検索順位は上がりますか
公式ドキュメントに、順位が上がるという記述はありません。書かれている効果は、ページの意図を伝えると「Google はそのページをより正確に理解できるようになります」という理解の助けと、リッチリザルトの対象になりうることまでです。さらに構造化データが原因の手動対策について「ページがリッチリザルトとして表示されなくなります。ただし、Google ウェブ検索でのページの掲載順位には影響しません」と明記されています。壊しても順位が落ちないものは、上げる方向にも効いていないと考えるのが自然です。変わるのは検索結果での見え方と、機械への伝わり方です。
個人ブログはどの構造化データから入れればいいですか
Article(ブログなら BlogPosting)からです。公開日・更新日・著者・タイトル・URLを入れます。Article には必須プロパティが無いので、自分のサイトで確実に言える項目だけを書けば足ります。次が BreadcrumbList ですが、画面にパンくずが出ているサイトに限りますし、検索結果に出るのはデスクトップのみです(2025年1月23日の公式ブログでモバイルの表示をやめると告知され、パンくずの構造化データのドキュメントの機能の提供状況の欄もパソコン版を対象にしています)。 FAQPage は後回しで構いません。
FAQPage は今も書く意味がありますか
リッチリザルト目的では、意味がなくなりました。2023年9月にFAQリッチリザルトの対象が「well-known, authoritative government and health websites」に絞られ、2026年5月7日以降は Google 検索に表示されなくなり、 6月15日にドキュメントごと削除されています。ただしAI検索など他の読み手がJSON-LDをどう使っているかは公表されていないので、価値がゼロだと確認できたわけではありません。言えるのは最初に手を付ける場所ではないということだけです。
本文とJSON-LDが食い違っていると、どうなりますか
Google の一般ガイドラインは「ページの読者に表示されないコンテンツをマークアップしないでください」と定めていて、構造化データはページ内容の true representation でなければならないとしています。違反するとリッチリザルトに出る資格を失う形で返ってきます。現実に多いのは悪意のある偽装ではなく、本文を直してJSON-LDを直し忘れるほうです。対処は「気をつける」ではなく、同じ値を2か所に書かない形にすることです。
まとめ
- 構造化データとは、ページの内容を機械が読める決まった形式で書き添えたもの。公式に書かれている効果は内容の理解とリッチリザルトまでで、正しく書いても表示は保証されない
- 順位のレバーではない。構造化データが原因の手動対策はリッチリザルトの資格を失うだけで、ウェブ検索の順位には影響しないと明記されている
- 入れる順番は①Article / BlogPosting(公開日・更新日・著者)②BreadcrumbList ③WebSite などサイトの実体に合うもの。②は画面にパンくずがあるサイト限定・検索結果はデスクトップのみ
- FAQPage は後回しでよい。2023年9月に対象が絞られ、2026年5月7日以降は表示されず、6月15日にドキュメントが削除された。ただし価値がゼロだと確認できたわけではない
- このサイトは2026年8月17日に記事66本(当時)へ BlogPosting を入れ、本文と同じ配列からJSON-LDを作れない FAQPage は見送った。食い違いを防ぐのは注意力ではなく、食い違えない形にすること
- 入れてはいけないのは①ページに見えていない内容を書く ②本文とJSON-LDを別々に書いて食い違わせるの2つ。後者のほうが頻度が高い
ここから先は、私が作ったツールの話です。
構造化データを整え終えたら、リライトレーダーに記事のURLを入れて、見出しや本文の直す点を見てみてください。記事が数十本あるなら、Search Consoleのデータを入れると、どれから直すかの順番まで出ます。URLの診断で送るのは入れたURLだけで、本文は保存しません。Search Consoleの「ページ」タブのエクスポートをZIPのまま置くと、掲載順位4.0〜20.5位のページから手を入れる候補を順に並べます。判定と、そのうち1記事分の診断カードまでは無料です。有料は2,980円(税込)の買い切りで3記事分(候補が4件以上のときだけご案内)、生成の期限は購入から90日間で、月額課金はありません。CSVはブラウザの中で読み、送るのは候補ページのURLと、診断カードを出すときの狙いキーワード・順位・表示回数・CTRだけです。
⚠️ URLの診断は本文だけを読み、順位・表示回数・CTRは使いません(それらを使うのはSearch Consoleのデータを入れたときです)。構造化データを検査するツールでも、入れた効果を測る道具でもありません。
記事のURLを貼るだけで、本文の改善点を無料で確認できます。登録は不要です。Search ConsoleのZIPを読み込むと、候補の判定と1記事分の診断カードも無料です。